
AI 時代的「空間煉金術」:Marvell 如何用 CXL 壓縮打破記憶體牆?
在 AI 伺服器與資料中心瘋狂擴張的今天,業界最大的痛點早就不是運算核心(Compute)不夠快,而是記憶體(Memory)跟不上。AI 模型的參數總量以指數級暴增,導致硬體設計一腳撞上了高聳的「記憶體牆」 (Memory Wall)。
「DDR 壓縮」技術主要用來解決 AI 伺服器與資料中心面臨的記憶體容量與頻寬瓶頸。雖然博通 (Broadcom) 在自研 AI 晶片 (ASIC) 與客製化記憶體整合上有深厚實力,但業界在 DDR 硬體壓縮技術的突破上,最受矚目的是邁威爾 (Marvell)。
一、 技術核心:Marvell 的 CXL 記憶體壓縮
面對高昂的 HBM 與實體 DDR 擴充成本,Marvell 的策略非常直接:既然實體空間有限,那就用硬體即時壓縮,把空間榨到極致。
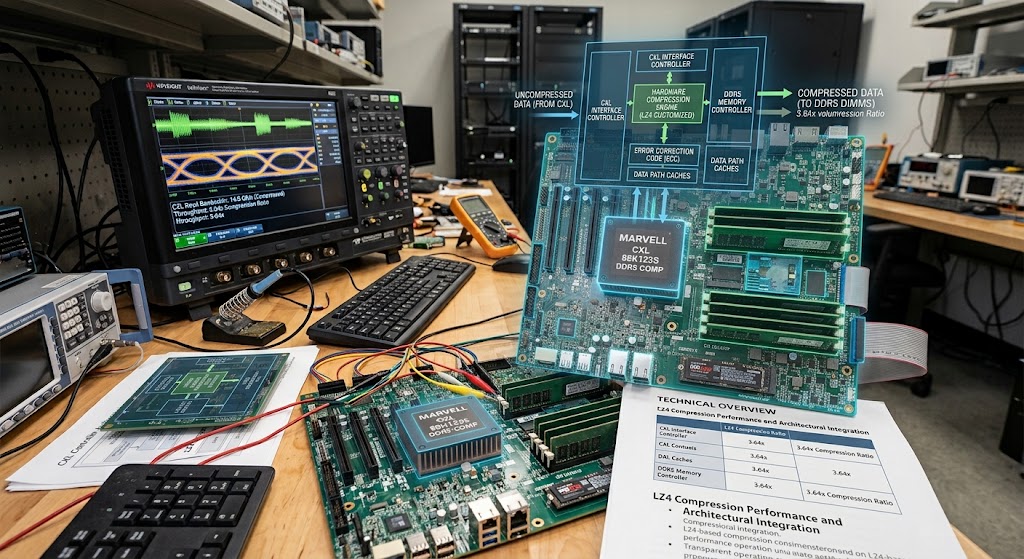
[CPU / GPU] <---> [ CXL 控制器 (內建客製化 LZ4 硬體引擎) ] <---> [ 實體 DDR 記憶體 ]
                         │                                              │
                         └─► 資料寫入:自動壓縮 ─────────────────────────► (節省高達 3.64x 空間)
                         └─► 資料讀取:同步解壓縮 ◄──────────────────────┘
-
運作原理與演算法: Marvell 將「硬體即時壓縮」功能直接整合至 CXL 控制器(可讓 CPU/GPU 共享與擴充記憶體的介面)。在演算法上,他們採用了客製化的 LZ4 壓縮演算法,全面支援主流的 DDR5 與 DDR4 規格。
-
效能表現: 當資料寫入 DRAM 時,控制器會自動進行壓縮;讀取時,則同步進行解壓縮。根據官方數據,這種架構最高可將有效記憶體容量提升至實體容量的 3.64 倍。
-
關鍵硬體優勢:
-
不吃 CPU 資源: 整個壓縮和解壓縮的過程,完全由 CXL 控制器內建的硬體晶片(Hardware Engine)獨自完成,完全不佔用寶貴的主運算資源。
-
對系統透明(System Transparency): 這一點對軟體端極其友善。作業系統(OS)完全不需要為了這個壓縮技術做出任何更改或重新編譯,就能直接部署上線。
-
二、 產業痛點:為什麼非要 DDR 壓縮不可?
要理解這個技術的商業價值,必須先看懂當前資料中心面臨的三大硬體困境:
-
AI 成長速度超乎想像: LLM(大型語言模型)的參數規模動輒數千億、甚至兆級。當模型大到無法完全塞進單一節點的記憶體時,就必須頻繁進行跨節點或跨晶片的資料交換,這直接拖累了 AI 的訓練與推論效率。
-
硬體建置成本高昂: 雖然 HBM(高頻寬記憶體)速度極快,但其成本高昂且產能極度受限;而純粹靠插滿實體 DDR 條來擴充容量,不僅受限於主機板空間(Form Factor),還會帶來恐怖的耗電量與散熱成本。
-
緩解記憶體牆與頻寬壓力: 透過 CXL 壓縮技術,等同於讓相同容量的 DDR 存放高達 3 倍以上的資料。這不僅變相放大了記憶體池(Memory Pool)的總量,更因為傳輸的資料體積變小,變相提升了實體頻寬的傳輸效率,精準緩解了頻寬瓶頸。
【技術註解】CXL
在深入 Marvell 的壓縮技術之前,我們必須先理解 CXL(Compute Express Link)本身。如果用一句話解釋:CXL 是一個將記憶體「分離」並「共用」的標準化高速互連介面。
CXL 克服這些問題的方式:解耦與共用
CXL 利用 PCIe 5.0/6.0 的物理層,但引入了專門的協議(CXL.mem, CXL.cache, CXL.io)。它將記憶體視為一個「可以分離的、可以共用的、統一的池」。
透過 CXL,計算節點(CPU、GPU、ASIC)可以像存取自己的 UMA 記憶體一樣,存取位於不同物理基板、甚至是不同節點的 CXL 記憶體池,且具有低延遲、高頻寬的特點。這不僅極大地方便了記憶體擴充,更讓跨節點的資源調度變得極其靈活,是資料中心向「解耦式架構」(Disaggregated Architecture)邁進的關鍵步。
傳統上,透過 PCIe 外接的裝置(如 NVMe SSD)存取速度很慢,因為要走複雜的 I/O 協議。 但 CXL 引入了 CXL.mem 協議,它讓 CPU/GPU 存取「透過 CXL 外接的記憶體池」時,就如同存取自己主機板上的本地記憶體一樣(低延遲、硬體層級快取一致性)。在軟體看來,這塊外接的巨大記憶體池,存取體驗非常接近本地記憶體。
要比較 CXL DDR(通常是 CXL Type-3 記憶體擴充模組)與本地直連(Direct-Attached)DDR 的存取延遲,我們必須看「空載延遲(Unloaded Latency)」,也就是在沒有頻寬擠塞的理想狀況下,晶片讀取一個資料塊所需的絕對時間。
以下為您列出業界(如 Micron、Samsung、Astera Labs 在 2025/2026 年最新實測與技術規格)的標準數據對比與延遲來源拆解:
數據直接對比(以 DDR5-4800 / 5600 為基準)
| 記憶體類型 | 絕對存取延遲 (奈秒, ns) | 相對延遲倍數 | 效能階層定位 |
| 本地直連 DDR5 (IMC) | 約 60 ~ 80 ns | 1.0x(基準) | 最快核心記憶體 |
| CXL DDR5 擴充模組 | 約 130 ~ 150 ns | 約 1.8x ~ 2.2x | 近本地端(Near-Local)記憶體層 |
| (對比)NVMe SSD 固態硬碟 | 約 10,000 ~ 15,000 ns (10-15 µs) | 約 150x ~ 200x | 慢速儲存裝置層 |
三、 Marvell 在 CPO (共同封裝光學) 的戰略佈局
除了用 CXL 壓縮在「運算-記憶體」端建立優勢外,Marvell 更進一步將觸角延伸至更高階的網路連接領域,大力佈局 CPO (Commonly Packaged Optics, 共同封裝光學)。
在超大型 AI 叢集(Cluster)中,晶片與晶片、架構與架構間的「互連頻寬」是限制整體算力的最終瓶頸。Marvell 意識到,單靠傳統的可插拔光纖模組(Pluggable Modules),在 1.6T 甚至未來 3.2T 以上的速度下,將面臨嚴重的能耗與信號衰減問題。
Marvell 的 CPO 佈局採取了全棧式的光學與封裝技術路徑:
-
自研 DSP 與驅動晶片: 利用其在 PAM4 DSP 設計上的優勢,為 CPO 提供最低功耗的驅動硬體。
-
OSP 平台整合: 開發「光學矽平台」 (Optical Silicon Platform),旨在將光學元件(如激光器、探測器、波導)與 ASIC 晶片以「Chip-to-Chip」的方式共同封裝在同一基板上。
-
極致低耗與密度: 透過 CPO,Marvell 旨在將光學互連的能耗大幅降低(目標是比可插拔模組節省 50% 以上能耗),同時將頻寬密度提升數倍。這對於維持超大型 AI 叢集在極限能耗下的持續運作至關重要。
此佈局使得 Marvell 成為少數能同時提供高效能運算互連(CXL 壓縮)與超高速網路互連(CPO)全方案的晶片大廠,在未來 AI 基礎設施市場中佔據極有利的位置。
四、 商業價值分析:IC 設計廠的戰略布局
從商業與市場競爭的角度來看,Marvell 透過 CXL 與 CPO 雙管齊下的策略,正精準地捕捉 AI 浪潮下的基礎設施需求:
| 評估維度 | 商業效益與市場策略 |
| 對資料中心客戶 (TCO) | 降低總體擁有成本 (TCO) 效果顯著。雲端服務供應商 (CSP) 無需購買高昂的實體硬體與負載更多電力,即可獲得 3 倍以上的記憶體效益與極致低能耗的網絡互連,滿足 AI 應用的重度需求。 |
| Marvell 的競爭壁壘 | 成功在 CXL 控制器與 CPO 市場同時樹立技術護城河。與博通專注在頂級自研 ASIC 的路線不同,Marvell 透過高相容性、高部署彈性的 CXL 方案,以及領先的 CPO 光學平台,能更廣泛地吃下標準化與客製化 AI 伺服器升級的龐大商機。 |
| 產業標準引領者 | 隨着 CXL 與 CPO 生態系逐漸成熟,這兩種技術將成為未來伺服器控制晶片與互連的「標配」。Marvell 的領先突破,有助於其在下一代資料中心基礎設施中,牢牢掌握話語權。 |